반응형

카프카 프로듀서란?

프로듀서는 어플리케이션에서 생성한 레코드를 카프카 브로커로 전송하는 역할을 담당 한다

카프카 프로듀서 흐름
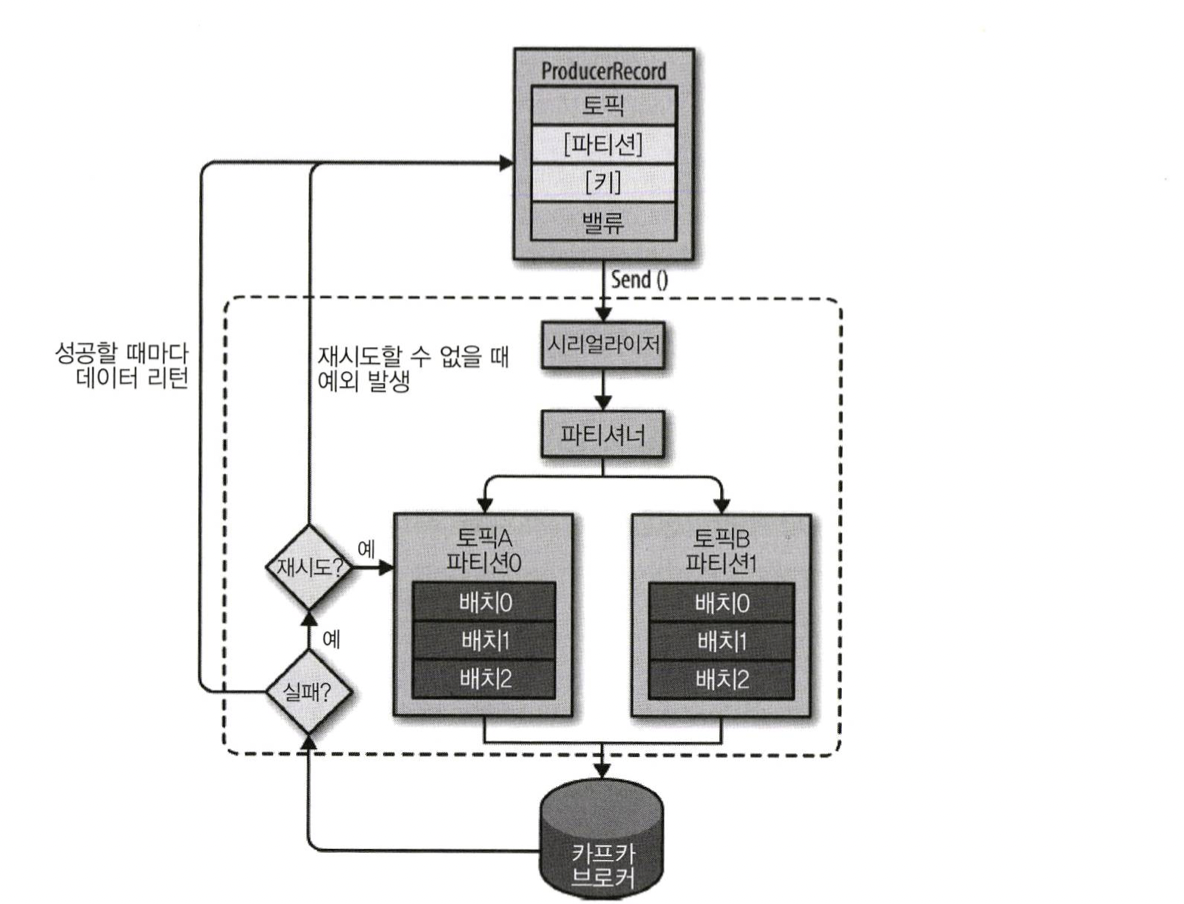
카프카 핵심 가이드

Produer Record

브로커로 보내기 위한 정보를 담은 객체

  • 토픽
  • 파티션 (option)
  • 키 (option)
  • 밸류
// 1. 파티션까지 직접 지정하는 경우
ProducerRecord<String, String> record = new ProducerRecord<>("토픽A", 0, "키값", "메시지내용");

// 토픽명 파티션 키 밸류
// 2. 파티션 없이 키만 지정 (파티셔너가 파티션 결정)
ProducerRecord<String, String> record = new ProducerRecord<>("토픽A", "키값", "메시지내용");

// 3. 파티션도 키도 없는 경우
ProducerRecord<String, String> record = new ProducerRecord<>("토픽A", "메시지내용");

카프카 프로듀서 메시지 전송 흐름

  • ProducerRecord 생성 (토픽, 파티션, 키, 값 등 포함)
  • 직렬화(Serializer): 키와 값을 바이트 배열로 변환
  • 파티셔너(Partitioner): 어느 파티션으로 보낼지 결정 (키가 있으면 해시 기반, 없으면 라운드로빈 등)
  • 레코드 배치(RecordAccumulator): 같은 파티션으로 가는 레코드를 배치로 묶음
  • 전송 스레드가 배치를 브로커로 전송
  • 성공 시 RecordMetadata 반환, 실패 시 예외 처리

프로듀서 생성

  • bootstrap.servers: 브로커 목록
    • 브로커 동작 이슈 대비하여 최소 2개 이상 권장
  • key.serializer, value.serializer: 직렬화 클래스 지정
    • ByteArraySerializer
    • StringSerializer
    • IntegerSerializer

메시지 전송 방식

파이어 앤 포켓

  • 메시지를 전송한 후 결과를 확인 안함

동기적 전송

  • 메시지를 전송한 후 반환 되는 Future 객체의 get 메서드를 호출하여 결과를 수신할 때 까지 대기하고 결과 수신 후 다음 처리를 진행

비동기적 전송

  • 메시지를 전송 후 브로커로부터 응답을 수신 받을 시점에 callback 함수를 호출하여 별도 비즈니스 로직을 처리

프로듀서 설정

  • client.id : 프로듀서와 애플리캐이션을 구분하기 위한 논리적 식별자
  • acks: 메시지 전달 신뢰성 수준 (0, 1, all/-1)
    • 0 : 메시지가 성공적으로 전달되었다고 간주하고 브로커의 응답을 기다리지 않음
    • 1 : 리더 레플리카가 메시지를 받는 순간 브로커로부터 성공했다는 응답을 받음
    • all/-1 : 메시지가 모든 인-싱크 레플리카에 전달된 뒤에 브로커로부터 성공했다는 응답을 받음
  • buffer.memory: 전송 대기 중인 메시지를 위한 버퍼 크기
  • compression.type: 압축 방식 (snappy, gzip, lz4, zstd)
  • retries / retry.backoff.ms: 재시도 관련 설정
  • batch.size, linger.ms: 배치 크기와 대기 시간 (처리량 vs 지연시간 트레이드오프)
  • max.in.flight.requests.per.connection: 순서 보장과 관련된 설정
  • max.request.size: 최대 요청 크기

카프카 핵심 가이드

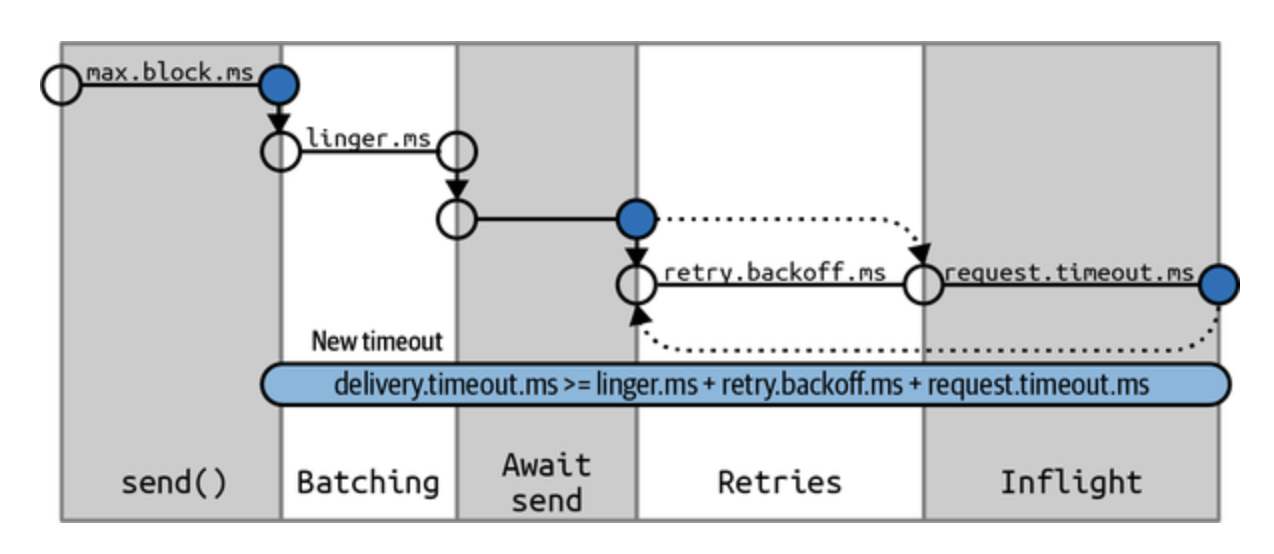
delivery.timeout.ms >= linger.ms + retry.backoff.ms + request.timeout.ms

max.block.ms : send를 호출 했을 때, 버퍼가 꽉 차있거나 메타데이터를 아직 못 가져오는 경우 최대 대기 시간
linger.ms : 메시지를 바로 보내지 않고, 배치로 묶기 위해 추가로 기다리는 시간
retry.backoff.ms : 전송이 실패했을 때 재시도하기 전 대기하는 시간
request.timeout.ms : 실제로 브로커에 요청을 보낸 후, 브로커의 응답을 얼마나 기다릴지 정하는 시간

시리얼라이저

기본 시리얼라이저

시리얼라이저 대상 타입
StringSerializer String
IntegerSerializer Integer
LongSerializer Long
DoubleSerializer Double
ByteArraySerializer byte[]

커스텀 시리얼라이저

Serializer인터페이스를 구현하여 Custom 시리얼라이저를 만들 수 있다

public class Customer {
    private int customerID;
    private String customerName;
    // getter, setter 생략
}

public class CustomerSerializer implements Serializer<Customer> {
    @Override
    public byte[] serialize(String topic, Customer data) {
        // customerID(4바이트) + customerName 길이(4바이트) + customerName(바이트)
        // 형태로 직접 바이트 배열을 조립
        ...
    }
}

커스텀 시리얼라지어의 문제점

  • 스키마 변경에 취약함
    • 예: Customer 객체에 email 필드를 나중에 추가하면, 새 버전으로 보낸 메시지를 예전 버전의 컨슈머(디시리얼라이저)가 읽으면 파싱이 깨지거나 에러 발생
    • 프로듀서와 컨슈머 간의 스키마 호환성을 스스로 관리해야 하는 부담이 생김
  • 유지보수 어려움
    • 필드가 추가/삭제될 때마다 시리얼라이저와 디시리얼라이저 코드를 양쪽 다 수정해야 함
    • 여러 팀, 여러 서비스가 같은 토픽을 사용하는 경우 동기화가 매우 어려워짐
  • 재사용성 부족
    • 객체마다 매번 새로운 시리얼라이저 작성 필요

Avro

아파치에서 만든 직렬화 시스템
데이터 구조를 스키마로 별도 정의하고, 스키마를 기반으로 직렬화/역직렬화를 수행

  1. 스키마와 데이터 분리
    • Avro는 데이터를 쓸 때 사용한 스키마와 읽을 때 사용하는 스키마가 완전히 같지 않아도 호환되도록 설계
  2. 스키마 진화(Schema Evolution) 지원
    • 필드 추가/삭제 시에도 하위 호환성(backward compatibility) 또는 상위 호환성(forward compatibility)을 유지 가능
  3. 스키마 레지스트리(Schema Registry) 연동
    • 실무에서는 보통 Avro를 Confluent Schema Registry와 함께 사용
    • 동작 방식:
      1. 프로듀서가 메시지를 보낼 때, 스키마를 레지스트리에 등록 (또는 이미 등록된 스키마 ID 조회)
      2. 메시지 안에는 스키마 전체가 아니라 스키마 ID만 포함해서 전송 → 메시지 크기 절약
      3. 컨슈머는 메시지에 포함된 스키마 ID로 레지스트리에서 해당 스키마를 조회해 역직렬화
    • 이 구조 덕분에 프로듀서와 컨슈머가 서로 다른 버전의 스키마를 사용해도 자동으로 호환성이 체크 보장

예시

[프로듀서]
Customer 객체 → Avro 스키마 기반 직렬화 → 바이트 + 스키마ID
        ↓
   Schema Registry에 스키마 등록/조회
        ↓
   카프카 브로커로 전송

[컨슈머]
바이트 + 스키마ID 수신
        ↓
   Schema Registry에서 스키마ID로 스키마 조회
        ↓
Avro 역직렬화 → Customer 객체 복원

파티션

파티셔너(Partitioner)의 역할

프로듀서가 메시지를 보낼 때, 어느 토픽의 몇 번 파티션에 저장할지 결정하는 컴포넌트

시리얼라이저 (바이트 변환)
      ↓
파티셔너 ← 여기서 파티션 결정
      ↓
배치 큐 (해당 파티션으로)
  • 같은 파티션 내에서는 메시지 순서가 보장

키가 있는 경우 - 해시 기반 파티셔닝

동작 방식
  • 기본 파티셔너(DefaultPartitioner)는 키의 해시값을 파티션 개수로 나눈 나머지를 이용해 파티션 결정
partition = hash(key) % 파티션개수
특징
  • 같은 키는 항상 같은 파티션으로 감 → 이게 핵심 포인트
  • 예: 키가 "user123"인 메시지는 항상 같은 파티션으로 전송됨
  • 컨슈머 입장에서 봤을 때 같은 키를 가진 메시지들끼리는 순서가 보장됨
    주의할 점
  • 파티션 개수가 변경되면 해시 결과가 달라짐 → 기존에 매핑되던 파티션과 달라질 수 있음
  • 그래서 토픽의 파티션 수는 운영 중 함부로 늘리지 않는 것이 권장됨 (특히 키 기반 파티셔닝을 사용할 때)

키가 없는 경우 - 라운드로빈 / Sticky 방식

키가 없을 때의 동작
  • 키가 없으면 해시 계산을 할 대상이 없으므로, 파티션에 고르게 분산시키는 방식 사용
Sticky 방식으로 바뀌었나
  • 순수 라운드로빈은 매번 파티션을 바꾸다 보니, 배치가 작은 상태로 여러 파티션에 흩어져 전송되는 비효율 발생
    • 배치 효율 저하 → 처리량 저하
  • Sticky Partitioner는 같은 파티션에 메시지를 모아 배치 크기를 키워서 전송 효율(처리량)을 높이는 것이 목적
  • 장기적으로 보면 전체 파티션에 고르게 분산되는 건 동일하되, 배치 단위로 묶어서 보내는 효율성 개선
커스텀 파티셔너 (Custom Partitioner)

기본 해시 기반 방식으로는 해결이 안 되는 비즈니스 로직상의 특수한 분배 요구가 있을 때 사용

  • Partitioner 인터페이스 구현

헤터, 인터셉터, 쿼터

헤더 (Headers)

카프카 메시지는 키와 밸류 외에 헤더(Header)라는 별도의 키-값 쌍 목록을 가질 수 있다.
메시지 본문(밸류)을 건드리지 않고 부가적인 메타데이터를 함께 전달하고 싶을 때 사용한다.

예시

ProducerRecord<String, String> record = 
    new ProducerRecord<>("토픽A", "키값", "메시지내용");

record.headers().add("traceId", "abc-123".getBytes(StandardCharsets.UTF_8));
record.headers().add("source", "order-service".getBytes(StandardCharsets.UTF_8));

producer.send(record);

인터셉터 (ProducerInterceptor)

메시지가 전송되기 직전 또는 전송 완료(성공/실패) 직후에 공통 로직을 자동으로 끼워 넣을 수 있는 훅(hook)이다.
애플리케이션 코드를 수정하지 않고도 프로듀서 동작에 공통 처리를 추가할 수 있다.

  • ProducerInterceptor<K, V> 인터페이스 구현
    • onSend: 시리얼라이저, 파티셔너를 거치기 전 send를 호출한 직후
    • onAcknowledgement: 브로커로부터 응답(성공/실패)을 받은 직후
    • close: 프로듀서 종료 시
public class CountingProducerInterceptor implements ProducerInterceptor<String, String> {

    @Override
    public ProducerRecord<String, String> onSend(ProducerRecord<String, String> record) {
        // 전송 전: 헤더에 타임스탬프 추가
        record.headers().add("sentAt", 
            String.valueOf(System.currentTimeMillis()).getBytes());
        return record;
    }

    @Override
    public void onAcknowledgement(RecordMetadata metadata, Exception exception) {
        // 전송 후: 성공/실패 카운트
        if (exception != null) {
            System.out.println("전송 실패: " + exception.getMessage());
        } else {
            System.out.println("전송 성공, 오프셋: " + metadata.offset());
        }
    }

    @Override
    public void close() {}

    @Override
    public void configure(Map<String, ?> configs) {}
}

쿼터 (Quotas)

카프카 브로커가 특정 클라이언트(프로듀서/컨슈머)의 처리량을 제한하는 기능
하나의 클라이언트가 브로커 자원을 독점해서 다른 클라이언트에게 영향을 주는 것을 방지하기 위한 장치

쿼터 종류
  • 프로듀서 쿼터: 특정 클라이언트가 브로커에 쓸 수 있는 초당 바이트 수 제한
  • 컨슈머 쿼터: 특정 클라이언트가 브로커에서 읽을 수 있는 초당 바이트 수 제한
  • 요청 쿼터: 브로커 요청 처리 시간(CPU 사용률) 기준 제한
동작 방식
  • 클라이언트가 할당된 쿼터를 초과하면, 브로커는 응답을 지연(throttle)시켜서 클라이언트가 자연스럽게 속도를 줄이도록 유도
  • 요청을 거부하는 게 아니라 응답 지연을 통해 속도 조절
필요 이유
  • 특정 프로듀서가 갑자기 대량의 메시지를 쏟아내면, 브로커의 네트워크/디스크 자원을 독점하게 되어 다른 프로듀서, 컨슈머의 성능이 저하될 수 있음
  • 이를 막기 위해 브로커 관리자가 클라이언트별로 초당 처리 가능한 바이트 수(byte rate)를 제한
반응형

'공부 > Kafka' 카테고리의 다른 글

[Kafka] Kafka CLI  (0) 2025.08.29
[Kafka] Topic, Partition, Producer, Consumer  (0) 2025.08.29
[Kafka] Zookeeper와 Broker  (0) 2025.06.29
[Kafka] Kafka의 특징  (0) 2021.06.13
[Kafka: 카프카] Kafka란?  (0) 2021.06.07
반응형

해시 클러스터에서의 해시 몰림

  • 1 ~ 100, 101 ~ 200, 201 ~ 300 키 값이 한 구간에 몰리면 하나의 서버에만 부하가 받게 된다.
  • 클러스터 내에 해시 서버가 추가 또는 삭제되는 경우 리밸런싱 작업이 전체적으로 일어나면서 데이터의 이동과 변경이 발생하게 되고 그 과정에서 사용성이 떨어질 수 있다

해시 클러스터 내에서 안정적인 해시 운영을 위한 방법으로 다양한 방법이 있지만 안정해시라는 개념을 통해 해시 클러스터 내에 해시 데이터를 안정적으로 관리한다.

안정 해시의 컨셉

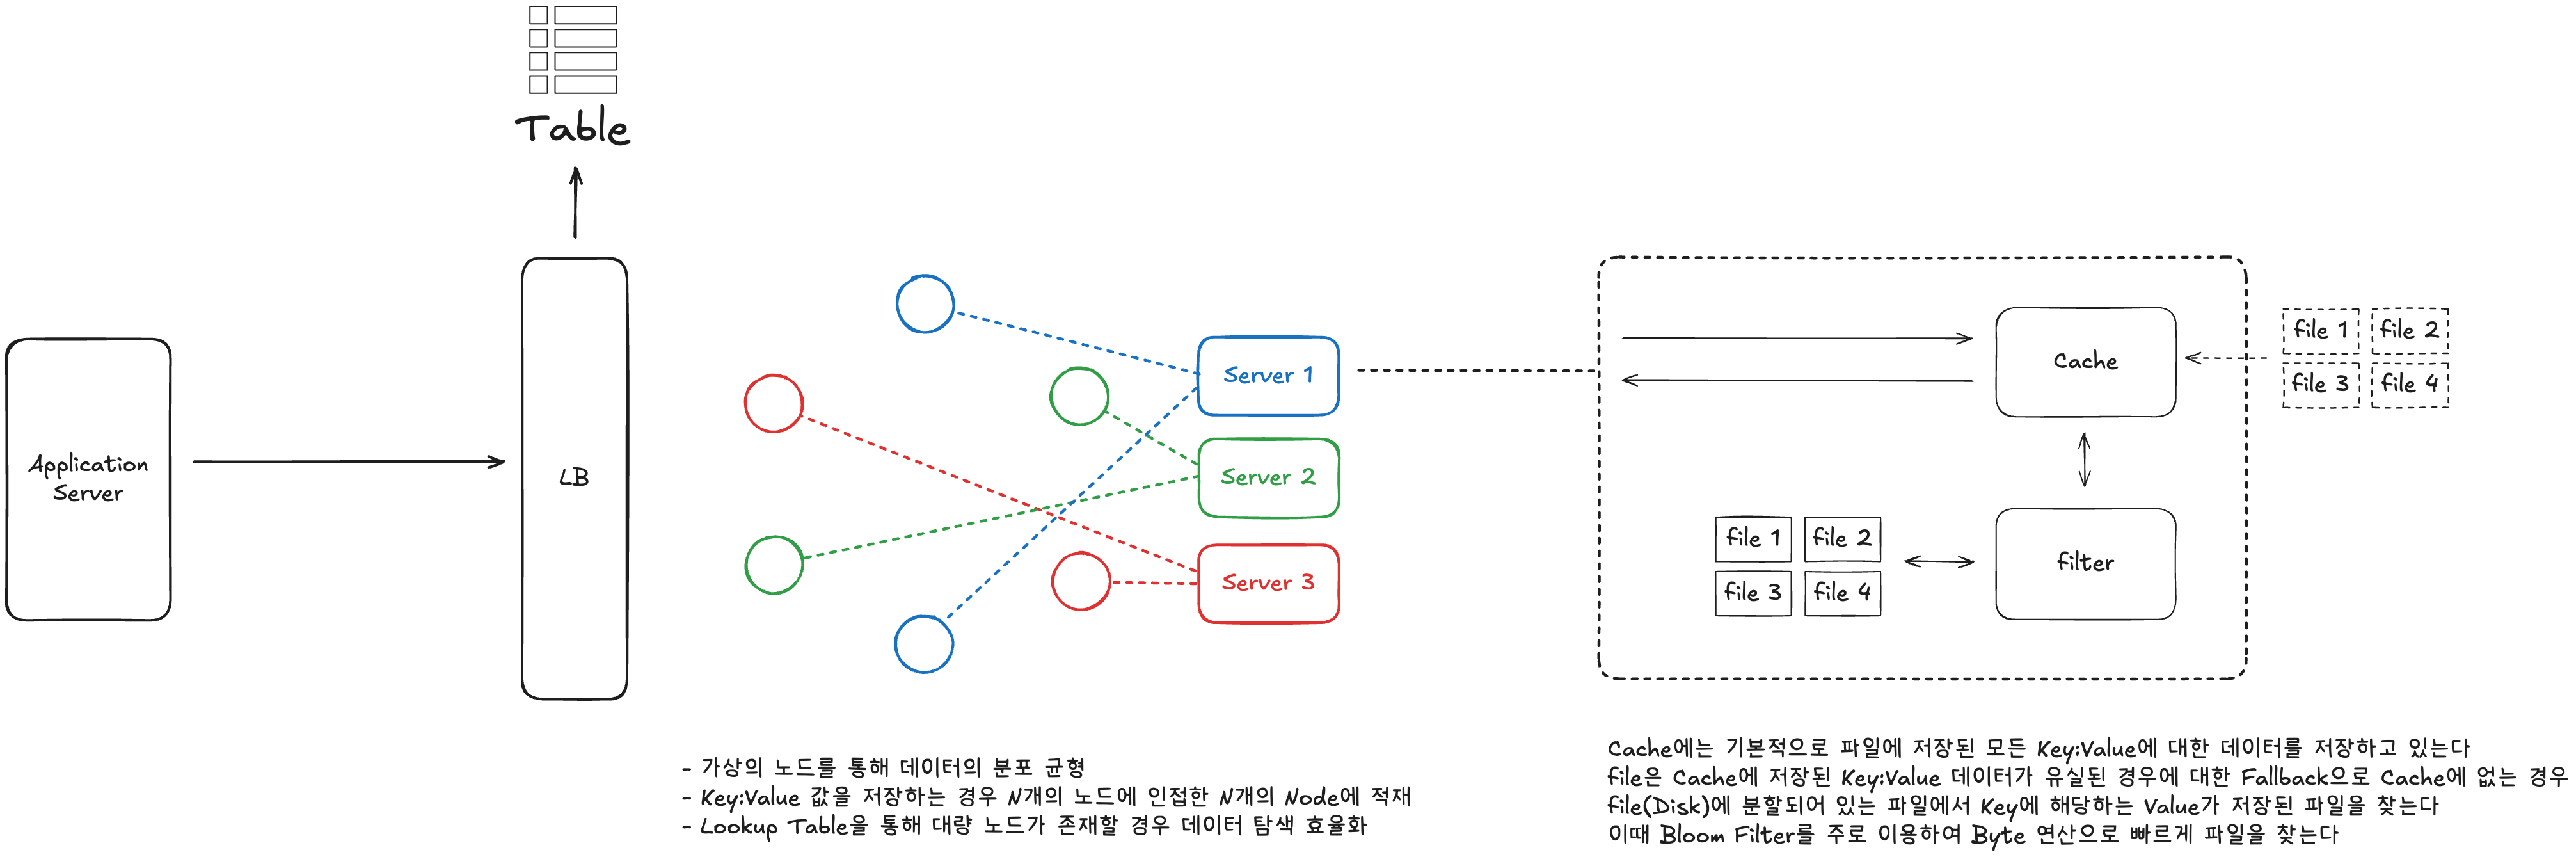
  • 안정 해시의 컨셉은 링이다
  • 링에 의해 한방향으로 가까운 노드에 해시 값을 저장 또는 삭제한다
  • 노드가 추가되면 링 위에 새로운 노드가 위치하고 한방향으로 가까운 노드만 리밸런싱을 하게 되어 다른 노드들은 영향을 받지 않게 된다

안정 해시의 문제점

  • 안정 해시도 결국 쏠림 현상이 발생할 수 있다
  • 이벤트성 트래픽에서는 특정 데이터에 몰릴 수 있는 문제가 생길 수 있다

안정 해시 쏠림 현상 개선

  • 가상 노드를 통해 링 위에 가상 노드를 다른 노드들 사이에 배치한다
  • 가상 노드의 수를 늘릴 수 록 노드 하나가 담당하게 되는 파티션의 크기가 작아지기 때문에 데이터가 균등하게 분포하게 된다

설계

  • CAP : AP(가용성 + 분단 허용성)
    • 일관성을 유지함에 따라 분단 허용성을 지킬 수 없음
    • 결과적 일관성을 통한 일관성 유지
  1. 링형 아키텍처 적용(양 끝을 연결한다는 것으로 논리적으로 링형)
    • 해시 키에 인접한 노드를 찾아감
  2. Virtual Node 적용
    • 가상 노드를 링 위에 인접하지 않도록 배치하여 적재되는 데이터의 분포를 균등하게 함
  3. 적재되는 데이터를 인접 노드에 함께 저장하여 장애 내성을 갖춤
  4. 해시키 범위 별 참여하고 있는 Lookup 테이블을 관리하는 방식 적용
  5. 데이터 저장시 저장 성공을 위한 성공 Node 수 관리

아키텍처 구성

처리 흐름

get

sequenceDiagram
    autonumber
    participant Client as 클라이언트
    participant Coord as LB
    participant Table as Lookup 테이블
    participant NodeA as Node A 
    participant NodeB as Node B 
    participant NodeC as Node C 

    Client->>Coord: GET(Key)
    activate Coord

    Coord->>Table: hash 값이 속한 담당 범위 조회
    activate Table

    Table-->>Coord: Primary = NodeA<br/>Replica Set = [NodeB, NodeC] (링 상 다음 N-1개 노드)
    deactivate Table

    Coord->>NodeA: GET(Key) 요청 [Primary]
    activate NodeA

    alt NodeA 정상 응답
        NodeA-->>Coord: Value 반환
    else NodeA 장애 / 타임아웃
        deactivate NodeA
        Coord->>NodeB: GET(Key) 요청 [인접 Node]
        activate NodeB
        alt NodeB 정상 응답
            NodeB-->>Coord: Value 반환
        else NodeB도 장애
            deactivate NodeB
            Coord->>NodeC: GET(Key) 요청 [다음 인접 Node]
            activate NodeC
            NodeC-->>Coord: Value 반환
            deactivate NodeC
        end
    end

    Coord-->>Client: Key : Value 응답
    deactivate Coord

put

sequenceDiagram
    autonumber
    participant Client as 클라이언트
    participant Coord as LB
    participant Table as Lookup 테이블
    participant NodeA as Node A
    participant NodeB as Node B
    participant NodeC as Node C

    Client->>Coord: PUT(Key, Value)
    activate Coord

    Coord->>Table: hash 값이 속한 담당 범위 조회
    activate Table
    Table-->>Coord: NodeA<br/>인접 노드 = [NodeB, NodeC] (N-1개 노드)
    deactivate Table

    Coord->>NodeA: PUT(Key, Value) 저장 요청 [Primary]
    activate NodeA
    NodeA-->>Coord: ACK (저장 성공)
    deactivate NodeA

    Coord-->>Client: PUT 성공 응답
    deactivate Coord

    par 인접 노드 비동기 복제
        Coord->>NodeB: PUT(Key, Value) 복제 [인접 Node]
        activate NodeB
        NodeB-->>Coord: ACK (복제 완료)
        deactivate NodeB
    and
        Coord->>NodeC: PUT(Key, Value) 복제 [다음 인접 Node]
        activate NodeC
        NodeC-->>Coord: ACK (복제 완료)
        deactivate NodeC
    end

인접 노드에 대한 복제 시 비동기 워커를 통한 복제
이때 몇개의 노드에 복제되었을 때 저장이 완료되게 할지에 대한 설정 필요

Cluster에 서버 추가

sequenceDiagram
    autonumber
    participant New as 신규 서버
    participant Coord as LB
    participant Table as Lookup 테이블
    participant Succ as 기존 인접 서버 (승계자)

    New->>Coord: 클러스터 참여 요청 (Join)
    activate Coord

    Coord->>Coord: 신규 서버의 가상 서버 해시 위치 계산

    Coord->>Table: 가상 서버 위치를 링에 삽입
    activate Table
    Table->>Table: 삽입 위치 기준 시계방향으로<br/>가장 가까운 기존 가상 서버 탐색<br/>→ 분할될 범위 산정
    Table-->>Coord: 이관 대상 범위 + 기존 담당 서버 반환
    deactivate Table

    Coord->>Succ: 분할 범위에 해당하는 Key 이관 요청
    activate Succ
    Succ->>New: 해당 범위 Key:Value 복사
    activate New
    New-->>Succ: 이관 완료 ACK
    deactivate New
    Succ-->>Coord: 마이그레이션 완료 보고

    Coord->>Table: Lookup 테이블 갱신
    activate Table
    Table-->>Coord: 갱신 완료
    deactivate Table

    Coord->>Succ: 이관 완료된 Key 삭제
    Succ-->>Coord: 삭제 완료
    deactivate Succ

    Coord-->>New: 서버 추가 완료 응답
    deactivate Coord

Cluster에 서버 삭제

sequenceDiagram
    autonumber
    participant Leave as 제거 대상 서버
    participant Coord as LB
    participant Table as Lookup 테이블
    participant Succ as 인접 서버 (승계자)

    Leave->>Coord: 클러스터 제거 요청
    activate Coord

    Coord->>Table: 이탈 서버의 가상 서버 위치 조회
    activate Table
    Table->>Table: 링 상에서 시계방향으로<br/>가장 가까운 다음 가상 서버 탐색<br/>→ 승계할 서버 결정
    Table-->>Coord: 이관 대상 범위 + 승계 서버 반환
    deactivate Table

    Coord->>Leave: 보유 중인 Key 전체 이관 요청
    activate Leave
    Leave->>Succ: 담당 범위 Key:Value 복사
    activate Succ
    Succ-->>Leave: 이관 완료 ACK
    deactivate Succ
    Leave-->>Coord: 마이그레이션 완료 보고
    deactivate Leave

    Coord->>Table: Lookup 테이블 갱신
    activate Table
    Table-->>Coord: 갱신 완료
    deactivate Table

    Coord-->>Leave: 클러스터 제외 및 종료 승인
    deactivate Coord
반응형
반응형

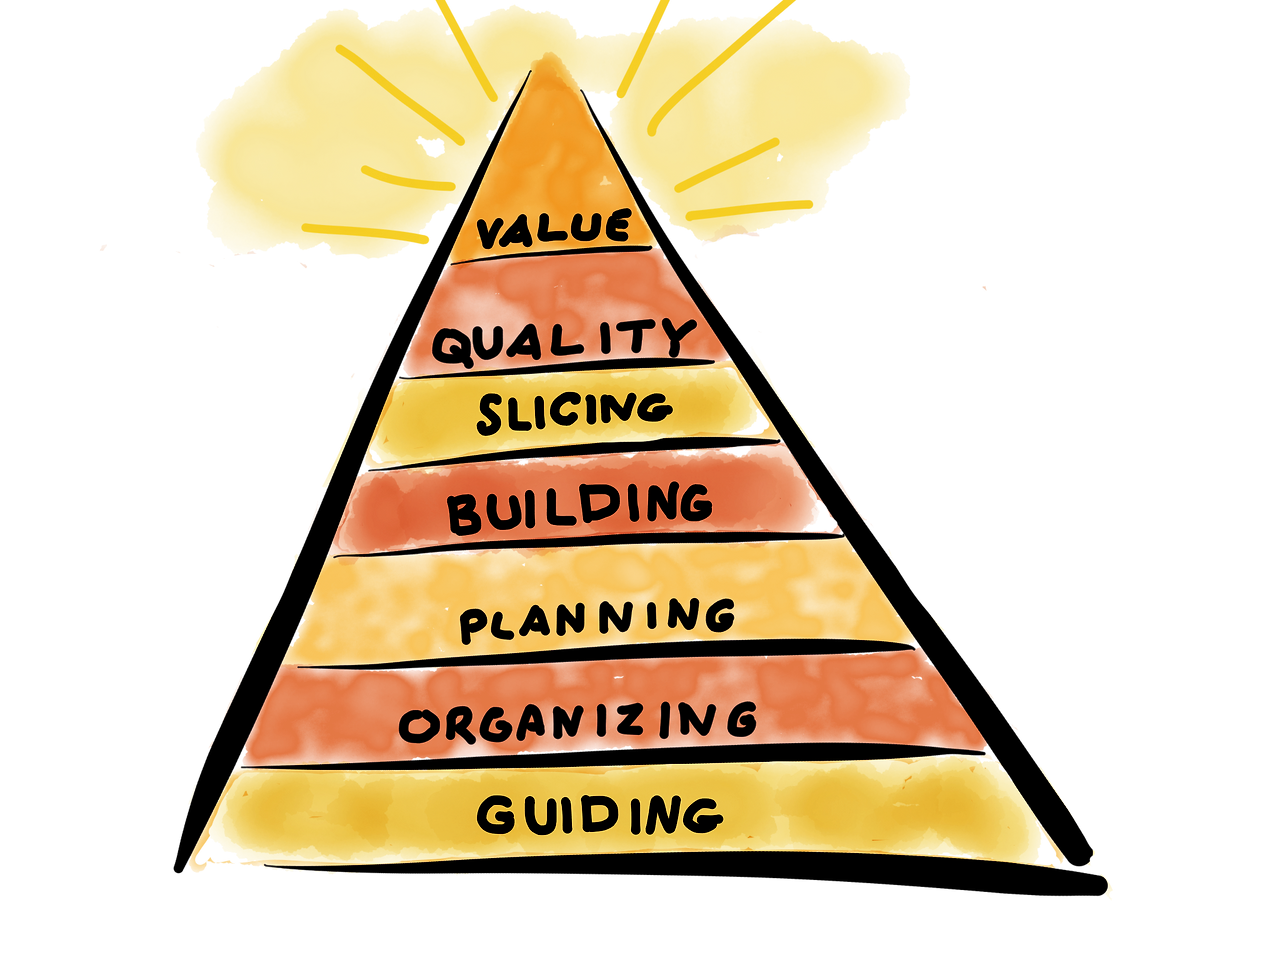
이 책은 애자일에 대한 책으로 가치있는 것을 빠르게 보여주고 피드백 받으면서 목표를 달성하기 위한 수단과 방법을 소개하는 책이다.


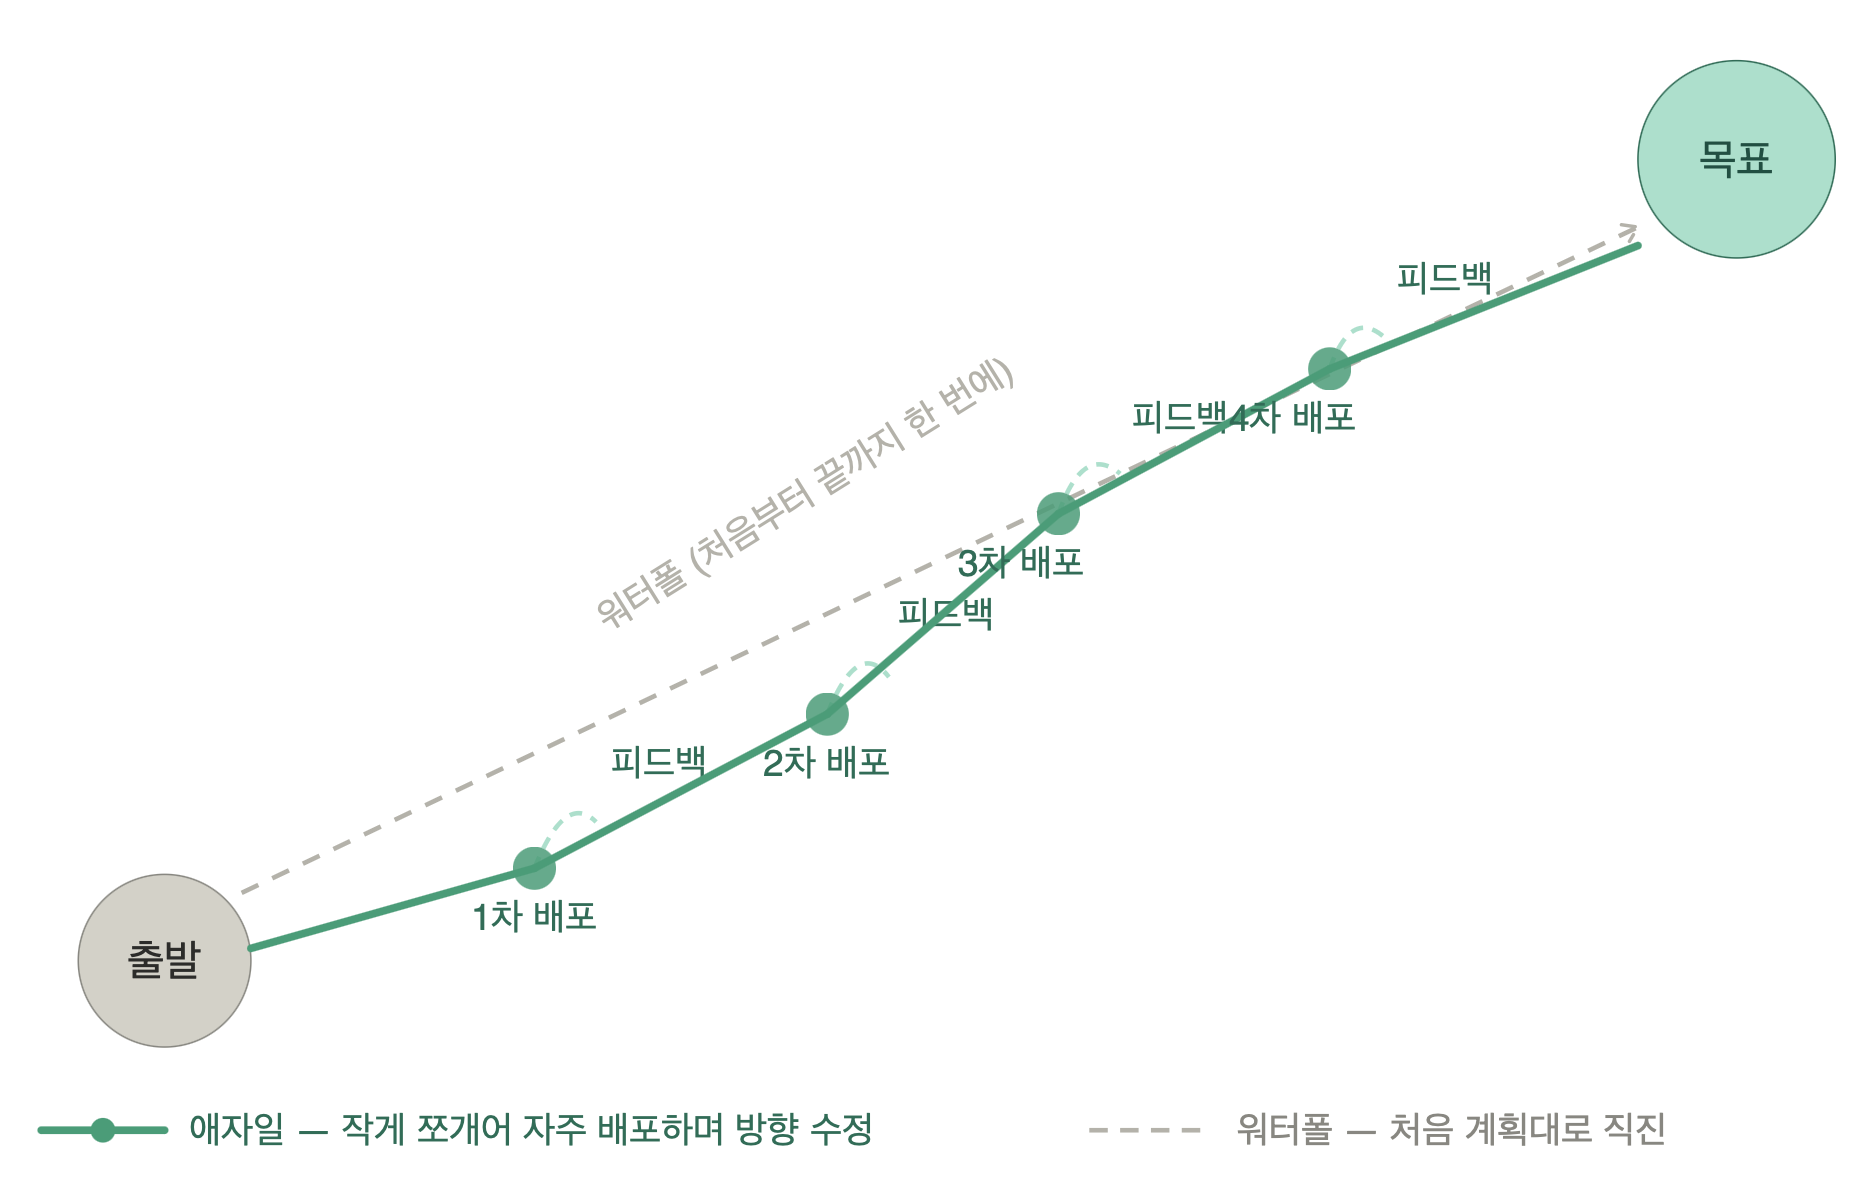
크게 계획하고 나중에 한 번에 보여주는 것이 아니라, 작게 쪼개서 지금 보여주는 것.

자주 틀리고 빠르게 수정하는 것이 한 번에 완벽하게 맞추려는 것보다 훨씬 낫다는 이야기다.


이 책을 보고 든 이미지는 아래와 같다.


출발점에서 목표까지 일직선으로 달리는 것이 아니라, 방향을 확인하며 조금씩 꺾어가는 화살표이다.

중요한 건 목표에 가까워지고 있느냐다.


우리가 애자일한 방법을 추구해야하는 이유는 아래의 워터폴의 문제를 들여다 보면 공감할 수 있다.

처음에 완벽하게 계획했다고 생각했던 것이 끝에 다다를 즘에 틀렸다는 걸 알게 된다.

하지만 그때는 이미 되돌아가기엔 너무 늦는다.


물론 애자일이 항상 옳은 것은 아니다.

요구사항이 처음부터 명확하게 고정된 프로젝트라면 굳이 애자일일 필요가 없을 것이다.


하지만 대부분의 소프트웨어 개발은 그렇지 않다.

요구사항은 바뀌고, 사용자가 원하는 것도 써봐야 안다.

그 불확실한 환경에서 피드백 루프를 통해 방향을 조정할 수 있다는 것, 그것이 애자일의 분명한 강점이다.


애자일에 대한 AI의 영향에 대한 생각

애자일의 핵심은 단순하다. 가치를 빠르고 자주 전달하는 것이다.

짧은 주기로 만들어서 보여주고, 피드백을 받아 방향을 수정한다.

그리고 이 사이클을 빠르게 돌릴수록 좋다.


AI는 이 사이클을 실질적으로 빠르게 만들어준다.

반복적인 코드 작성, 테스트 생성, 버그 수정에 개발자가 시간을 많이 쏟던 영역들은

AI에 의해 더욱 빠르게 처리된다.


결과적으로 더 자주 배포할 수 있고, 피드백을 더 빨리 받을 수 있고, 방향을 더 일찍 수정할 수 있다.

애자일이 원하는 사이클이 AI로 인해 비로소 완성되어가고 있는 모습이다.


애자일의 조력자 AI

AI가 애자일에 가져다주는 것들은 결국 하나의 방향으로 수렴한다.

사람이 해야 할 일에 더 집중할 수 있게 해준다는 것.


애자일에서 사람만이 할 수 있는 일이 있다.

무엇을 만들지 판단하는 것, 가치를 정의하는 것, 피드백을 해석하는 것, 팀이 같은 방향을 바라보게 하는 것.

이것들은 AI가 대신할 수 없다.

그리고 아이러니하게도, AI가 반복 작업을 빠르게 처리해줄수록 사람은 이 일에 더 많은 시간을 쏟을 수 있다.


"가치를 빠르고 자주 전달하는 것" 빠른 것은 수단이고 가치는 목적이다.

AI는 그 수단을 강력하게 만들어줬다.


경계해야할 것은?

AI가 빠르게 실행해줄수록 속도 자체가 목적이 되는 순간이 온다.

단순하게 빠르게 라는 것에만 매몰되면 애자일이 말하는 가치는 옅어지게 된다.


빠른 것은 수단이고 가치는 목적이다.

AI는 그 수단을 강력하게 만들어줬다.

목적을 잊지 않는 건 여전히 사람의 몫이다.


그렇다면 우리는 무엇을 해야 하는가

AI 시대에 개발자에게 필요한 것은 더 빠르게 쓰는 능력이 아니다.

멈추고 생각하는 능력, 가치를 판단하는 능력, 방향을 잡는 능력.

아이러니하게도 AI가 발전할수록 이 능력의 가치는 더 높아진다.


AI가 빠르게 달려줄수록, 어디로 달릴지 결정하는 사람의 역할은 더 중요해진다.

그것이 AI 시대에 애자일이 작동하는 방식일 것이다.


[References]


반응형

'' 카테고리의 다른 글

[책읽기] AI 시대를 관통하는 과학적 관리법  (0) 2026.03.30
반응형

Spring Batch에서 JpaPagingItemReader 같은 Paging 기반 Reader는 처음에는 꽤 합리적인 선택처럼 보인다.

한 번에 많은 데이터를 메모리에 올리지 않아도 되고, 일정 크기로 잘라 읽는 방식이어서 대량 처리에도 잘 어울려 보이기 때문이다.


그런데 실제 운영 환경에서는 이런 현상을 자주 만난다.

  • 처음 몇 페이지는 빠르다.
  • 중간 페이지부터 점점 느려진다.
  • 뒤 페이지로 갈수록 같은 page size인데도 처리 시간이 더 길어진다.
  • 전체 데이터가 늘수록 배치 시간이 비정상적으로 증가한다.

이러한 현상의 핵심 원인은 대부분 offset 기반 pagination의 구조적 비용에 있다.


문제는 "읽는 건수"보다 "버리는 건 수"에 있다

많은 사람이 Paging Reader를 이렇게 이해한다.

한 번에 1000건씩 읽으니까, 매 페이지 비용도 비슷하겠지.


겉으로 보면 맞는 말처럼 보인다.

실제로 애플리케이션이 받아오는 건수는 매번 limit 1000으로 동일하다.

하지만 DB가 그 1000건을 어떻게 찾아서 반환하는지까지 보면 이야기가 달라진다.


예를 들어 아래 같은 쿼리를 생각해보자.

select id, amount, created_at
from payment
where status = 'READY'
order by id asc
limit 1000 offset 0;

첫 페이지는 비교적 단순하다. 앞에서 버릴 데이터가 없기 때문이다.


그런데 500번째 페이지를 읽으면 쿼리는 이렇게 바뀐다.

select id, amount, created_at
from payment
where status = 'READY'
order by id asc
limit 1000 offset 499000;


마지막 구간에 가까워지면 이런 식이 된다.

select id, amount, created_at
from payment
where status = 'READY'
order by id asc
limit 1000 offset 900000;

애플리케이션은 여전히 1000건만 받는다.


하지만 DB는 그 1000건을 주기 전에 앞의 900000건을 지나가야 할 수도 있다.

즉, Paging Reader가 뒤 페이지로 갈수록 느려지는 이유는 더 많이 가져와서가 아니라, 더 많이 버려야 하기 때문이다.


Paging Reader는 실제로 어떻게 동작하는가

Spring Batch의 Paging Reader는 개념적으로 다음 흐름으로 동작한다.

  1. page 0 조회
  2. page 1 조회
  3. page 2 조회
  4. ...
  5. 마지막 page까지 반복

예를 들어 page size가 1000이면 내부적으로는 이런 조회가 이어진다.

-- 1 page
limit 1000 offset 0

-- 2 page
limit 1000 offset 1000

-- 3 page
limit 1000 offset 2000

-- 4 page
limit 1000 offset 3000

이 구조는 웹 화면에서 몇 페이지 정도 넘겨보는 정도라면 큰 문제가 아닐 수 있다.


하지만 배치는 다르다.

배치는 보통 첫 페이지부터 마지막 페이지까지 전부 읽는다.

즉, 큰 offset이 "가끔" 등장하는 것이 아니라, 언젠가 반드시 등장한다.


그래서 배치에서 Paging Reader의 성능 문제는 예외 상황이 아니라 구조적으로 누적되는 문제다.


offset 기반 pagination의 비용 모델

offset pagination의 핵심은 다음 두 숫자다.

  • limit: 최종적으로 반환할 건수
  • offset: 반환 전에 건너뛸 건수

많은 경우 limit는 작고 고정되어 있다. 예를 들어 1000건이다. 반면 offset은 페이지가 뒤로 갈수록 계속 커진다.

이때 비용을 지배하는 것은 대개 limit보다 offset이다.


예를 들어 총 100만 건이 있고, page size가 1000이라고 해보자.

  • 1페이지: offset 0
  • 100페이지: offset 99000
  • 500페이지: offset 499000
  • 1000페이지: offset 999000

반환 건수는 매번 1000건으로 같지만, DB가 도달해야 하는 위치는 점점 멀어진다.

이 때문에 뒤 페이지는 앞 페이지보다 느릴 가능성이 높다.


각 페이지의 반환 건수는 같지만, 각 페이지의 도달 비용은 같지 않다.

DB는 offset을 보고 "순간이동"하지 못한다

Paging을 사용하는 경우 보통 이렇게 생각을 하게 된다.

offset 900000이면 DB가 그냥 900001번째부터 바로 읽으면 되는 것 아닌가?


이렇게 생각하기 쉽지만, 실제 DB는 그렇게 단순하게 움직이지 않는다.

DB는 쿼리 조건과 정렬 조건을 만족하는 결과 집합을 만들고, 그 결과 중 앞의 offset개를 건너뛴 뒤 limit개를 반환해야 한다.


즉, offset 900000 limit 1000은 논리적으로 다음과 같은 의미에 가깝다.

  1. 조건에 맞는 후보를 찾는다.
  2. 정렬 기준에 맞춰 순서를 정한다.
  3. 앞의 900000건을 지난다.
  4. 그 다음 1000건을 반환한다.

DB 엔진과 실행 계획에 따라 세부 동작은 다르지만, 핵심은 같다.

큰 offset은 "바로 건너뛰는 숫자"가 아니라, 시스템이 감당해야 하는 작업량의 일부다.


정렬이 들어가면 왜 더 부담스러워질 수 있을까

Paging 쿼리는 거의 항상 order by와 함께 사용된다.

그런데 이 정렬은 생각보다 비용에 큰 영향을 준다.


예를 들어 아래 쿼리를 보자.

select id, amount, created_at
from payment
where status = 'READY'
order by created_at asc
limit 1000 offset 900000;

여기서 DB는 단순히 900001번째 행을 찾는 것이 아니라:

  • status = 'READY' 조건을 만족하는 대상을 찾고
  • created_at asc 순서를 맞추고
  • 그 순서에서 앞의 900000건을 건너뛴 뒤
  • 다음 1000건을 반환해야 한다

만약 where 조건과 order by를 함께 잘 받쳐주는 인덱스가 없다면, 부담은 더 커진다.

  • 더 많은 row 접근이 필요할 수 있다.
  • 정렬을 위한 추가 작업이 필요할 수 있다.
  • 임시 정렬 영역이나 filesort 성격의 비용이 발생할 수 있다.

뒤 페이지 성능 저하는 단순히 offset 숫자만의 문제가 아니라, 조건 + 정렬 + offset이 결합되며 커지는 경우가 많다.


인덱스가 있어도 왜 문제가 완전히 사라지지 않을까

이 주제를 쓰면 반드시 나오는 질문이 있다.

인덱스만 잘 잡으면 해결되는 것 아닌가?


인덱스는 분명 중요하다.

그리고 실제로 성능을 상당히 개선해줄 수 있다.

하지만 여기서 중요한 것은 인덱스가 offset pagination을 근본적으로 바꾸지는 못한다는 점이다.


인덱스가 잘 잡혀 있으면 다음이 좋아질 수 있다.

  • 조건 필터링 비용 감소
  • 정렬 비용 감소
  • Full scan 회피

하지만 인덱스가 있어도 큰 offset에서는 여전히 이런 부담이 남는다.

  • 인덱스 상에서 많은 엔트리를 따라가야 할 수 있다.
  • 원하는 위치에 도달하기 전까지 여러 row를 지나가야 한다.
  • 뒤 페이지일수록 누적 탐색 비용이 커진다.

인덱스는 offset paging을 덜 나쁘게 만들 수는 있어도, 뒤 페이지로 갈수록 느려지는 구조 자체를 없애지는 못한다.


배치에서 이 문제가 더 위험한 이유

웹 서비스의 목록 조회라면 사용자가 1페이지나 2페이지 정도만 보고 떠나는 경우가 많다.

심지어 100페이지 이후를 실제로 보는 사용자는 거의 없을 수도 있다.


하지만 배치는 다르다.

  • 첫 페이지부터 마지막 페이지까지 모두 읽는다.
  • 중간 페이지에서 멈추지 않는다.
  • 매일, 혹은 주기적으로 반복된다.
  • 데이터가 늘수록 마지막 offset도 같이 커진다.

웹에서는 offset 문제가 부분적으로 드러날 수 있지만, 배치에서는 그 비용이 항상 끝까지 누적된다.


예를 들어 오늘 10만 건이던 테이블이 몇 달 뒤 500만 건이 되면, page size가 그대로여도 뒤쪽 페이지 비용은 훨씬 무거워진다.

그래서 초기에는 별문제가 없어 보이던 배치가 운영 몇 달 후 갑자기 느려지는 경우가 생긴다.

실무에서는 이 패턴이 꽤 흔하다.


처음에는 충분히 빨랐는데, 데이터가 쌓이자 어느 날부터 새벽 배치가 윈도우 안에 끝나지 않는다.


이때 원인은 코드 복잡도보다도, 대개 offset 기반 순회 구조의 누적 비용에 있는 경우가 많다.


숫자로 보면 왜 후반부가 더 느린지 더 직관적이다

총 100만 건, page size 1000이라고 해보자.

각 페이지는 아래 정도의 skip 비용을 가진다.

  • 1페이지: 0건 skip
  • 10페이지: 9000건 skip
  • 100페이지: 99000건 skip
  • 500페이지: 499000건 skip
  • 1000페이지: 999000건 skip

마지막 페이지는 1000건을 받기 위해 앞의 거의 100만 건에 가까운 위치를 지나가야 할 수 있다.


이 관점에서 보면 page size가 같다는 사실은 큰 의미가 없다.

중요한 것은 최종적으로 몇 건을 반환하느냐가 아니라, 거기 도달하기 위해 얼마나 많은 데이터를 지나가야 하느냐다.


Spring Batch 코드로 보면 왜 더 헷갈리기 쉬운가

Spring Batch 코드만 보면 Paging Reader는 아주 단순해 보인다.

@Bean
fun paymentPagingReader(entityManagerFactory: EntityManagerFactory): JpaPagingItemReader<Payment> {
    val reader = JpaPagingItemReader<Payment>()
    reader.setName("paymentPagingReader")
    reader.setEntityManagerFactory(entityManagerFactory)
    reader.setPageSize(1000)
    reader.setQueryString(
        """
        select p
        from Payment p
        where p.status = :status
        order by p.id asc
        """.trimIndent()
    )
    reader.setParameterValues(
        mapOf("status" to PaymentStatus.READY)
    )
    return reader
}

애플리케이션 코드 관점에서는 그저 "1000건씩 잘 읽는 Reader"로 보인다.

그래서 많은 사람이 page size, chunk size, thread 수 같은 애플리케이션 설정만 튜닝하려고 한다.


하지만 실제 병목은 Reader 바깥, 즉 DB가 뒤 페이지에 도달하기 위해 치르는 offset 비용에 있을 수 있다.

그래서 이 문제는 Spring Batch 설정값만 바꿔서는 해결되지 않는 경우가 많다.


page size를 키우면 해결될까

이것도 자주 시도하는 대응이다.

  • 1000건이 느리면 5000건으로 키워본다.
  • 5000건이 느리면 10000건으로 키워본다.

물론 page 수가 줄어들기 때문에 전체 쿼리 횟수는 감소할 수 있다.

그래서 일정 수준의 개선은 있을 수 있다.


왜냐하면 page size를 키워도 여전히 offset 기반이면, 뒤 페이지는 여전히 큰 offset을 가진다.

단지 페이지 개수가 줄어들 뿐이다.

게다가 page size를 너무 키우면 다음 문제가 생긴다.

  • 한 번에 읽는 row 수 증가
  • 메모리 사용량 증가
  • 처리 시간 증가
  • 트랜잭션 부담 증가

page size 조정은 튜닝 포인트일 수는 있어도, 뒤 페이지 성능 저하의 근본 원인을 없애지는 못한다.


해결 방향: offset이 아니라 기준점으로 읽는다

이 문제를 근본적으로 줄이려면 페이지 번호를 기준으로 읽는 대신, 마지막으로 읽은 기준점을 기준으로 다음 데이터를 가져오는 방식이 더 적합하다.

흔히 keyset pagination 또는 seek 방식이라고 부른다.


예를 들어 아래 같은 쿼리다.

select id, amount, created_at
from payment
where status = 'READY'
  and id > :lastId
order by id asc
limit 1000;

이 방식은 offset 900000처럼 큰 숫자를 가지고 앞 데이터를 버리지 않는다.


대신 마지막으로 읽은 id 다음부터 바로 이어서 읽는다.

  • offset 방식: 몇 번째부터 읽을지 계산한다.
  • keyset 방식: 어디서부터 이어 읽을지 지정한다.

배치에서는 후자가 훨씬 잘 맞는다.

배치는 순차적으로 끝까지 읽는 작업이기 때문이다.


Kotlin 예시: key 기준으로 다음 페이지 읽기

fun findNextPage(lastId: Long, pageSize: Int): List<Payment> {
    return entityManager.createQuery(
        """
        select p
        from Payment p
        where p.status = :status
          and p.id > :lastId
        order by p.id asc
        """.trimIndent(),
        Payment::class.java
    )
        .setParameter("status", PaymentStatus.READY)
        .setParameter("lastId", lastId)
        .setMaxResults(pageSize)
        .resultList
}

이 방식의 장점은 분명하다.

  • 뒤 페이지로 갈수록 offset이 커지지 않는다.
  • 마지막 기준점 이후만 읽기 때문에 순차 처리에 적합하다.
  • 대량 데이터에서 후반부 성능 저하를 줄이기 쉽다.

물론 이 방식도 정렬 기준과 인덱스 설계가 중요하다.

하지만 적어도 "앞의 수십만 건을 버리고 다음 1000건을 읽는" 구조는 피할 수 있다.


마무리

Paging Reader가 뒤 페이지로 갈수록 느려지는 이유는 단순히 데이터가 많아서가 아니다.

offset 기반 조회가 뒤쪽으로 갈수록 더 많은 row를 건너뛰어야 하는 구조이기 때문이다.


하지만 Paging Reader를 사용하는 것 자체가 문제는 아니다.

데이터 양이 크지 않고, 조회 범위가 제한적이며, 뒤 페이지까지 깊게 순회하지 않는 상황이라면 Paging 방식은 여전히 단순하고 실용적인 선택이 될 수 있다.


결국 중요한 것은 Reader의 이름이 아니라 데이터의 양, 조회 패턴, 정렬 방식, 그리고 배치가 끝까지 어떤 방식으로 순회하는가다.

데이터가 계속 커지고 끝 페이지까지 모두 읽어야 하는 배치라면 offset 기반 Paging이 점점 불리해질 수 있고, 반대로 특정 구간만 가볍게 읽는 작업이라면 충분히 적합할 수도 있다.


배치에서는 "익숙한 Reader를 쓰는가"보다 현재 데이터 규모와 운영 상황에 맞는 Reader를 선택하고 있는가를 먼저 봐야 한다.

Paging Reader도 그 선택지 중 하나일 뿐이고, 상황에 따라서는 Cursor Reader나 keyset 방식이 더 적합할 수 있다.

반응형

'공부' 카테고리의 다른 글

안정 해시  (0) 2026.07.18
Redis Sorted Set (ZSet) 들여다 보기  (1) 2026.04.10
대기열 - 시스템 안정성 높이기  (0) 2026.04.02
Command와 Event  (0) 2026.03.27
서킷브레이커를 알았더라면  (0) 2026.03.20
반응형

들어가며

개발을 하다보면 "정렬된 상태를 유지해야 하는" 상황을 꽤 자주 마주친다.

이런 문제를 처음 마주쳤을 때 "DB에서 ORDER BY 하면 되지 않나?"라는 생각이 들게 되는데,

트레픽이 많은 경우에 매번 테이블을 조회하여 정렬된 데이터를 가져오는 것은 부담이 될 수 있다.


Redis의 Sorted Set(ZSet)을 활용하면 이러한 문제에서 조금 자유로울 수 있다.

데이터를 넣는 순간부터 항상 정렬된 상태를 유지하여 따로 정렬할 필요가 없다.


ZSet이란 무엇인가

ZSet은 각 멤버(member)에 score라는 숫자 값을 부여하고, 항상 score 기준으로 정렬된 상태를 유지하는 자료구조다. 일반 Set에 "순서"라는 차원이 하나 더 추가된 것이라고 봐도 된다.

  Set ZSet
중복 허용
순서 보장 ✅ (score 기준)
score


ZSet이 항상 보장하는 두 가지 성질이 있다.

유일성 — 같은 멤버는 하나만 존재한다. 이미 있는 멤버를 추가하면 score만 갱신

정렬 — 멤버는 score 오름차순으로 정렬된다. score가 동일하면 멤버 이름을 사전순으로 비교해 순서를 결정


단순해 보이지만, 이 두 성질을 삽입, 삭제가 발생할 때 마다 이를 위지하느 것은 꽤 부담이되어 보인다.

어떻게 이를 해결했을까?


내부 자료구조

ZSet의 성능 비결은 내부에서 두 가지 자료구조를 동시에 유지한다는 데 있다. 그 전에, 데이터 크기에 따라 구조 자체가 달라진다는 점을 먼저 이해하면 좋다.

인코딩 전략 — 작을 때와 클 때

ZSet은 데이터 규모에 따라 내부의 방식을 자동 전환한다.

멤버 수 ≤ 128  AND  각 멤버 크기 ≤ 64 bytes
  → listpack  (연속된 메모리 블록, 오버헤드 최소화)

그 외
  → skiplist + hashtable  (빠른 탐색과 조회를 위한 구조)

데이터가 적을 때는 단순한 연속 메모리 구조인 listpack을 써서 메모리를 절약한다.

그러다 임계값을 넘는 순간 자동으로 skiplist 기반 구조로 전환된다.

이 임계값은 zset-max-listpack-entrieszset-max-listpack-value 설정으로 조정할 수 있다.


실제로 운영 환경에서 ZSet을 쓰다 보면 어느 시점부터 메모리 사용량이 갑자기 늘어나는 것처럼 보이는 경우

대부분 이 인코딩 전환이 일어난 시점이다.


Skip List — 정렬과 범위 조회 담당

임계값을 넘어서면 ZSet은 Skip List로 전환된다.

Skip List는 연결 리스트에 "지름길" 역할을 하는 포인터를 여러 레벨로 추가한 자료구조다.

레벨 4 │ ──────────────────────────────────── [100]
레벨 3 │ ─────────── [30] ────────────────── [100]
레벨 2 │ ──── [10] ─ [30] ──── [60] ───────── [100]
레벨 1 │ [5]─[10]─[20]─[30]─[40]─[60]─[80]─[100]
                       ↑ score 오름차순

탐색할 때는 레벨이 높은 곳에서 시작해 목표 범위를 빠르게 좁힌다.

노드의 레벨은 삽입 시 확률적으로 결정되는데, Redis는 레벨업 확률로 25%를 사용한다.

이 덕분에 균형 트리(AVL, Red-Black Tree)와 비슷한 O(log N) 성능을 내면서도 구현이 훨씬 단순하다.


Skip List는 범위 기반 탐색에 특히 강하다.

"score가 100 이상 500 이하인 멤버 전부"를 가져오는 ZRANGEBYSCORE 같은 명령이 빠른 이유다.

연결 리스트 특성상 범위 내 다음 노드를 순서대로 따라가면 되기 때문이다.


span 필드

Redis의 Skip List는 각 포인터에 span이라는 값을 저장한다.

span은 그 포인터가 건너뛰는 노드 수를 의미한다. 포인터를 따라 이동하면서 span 값을 누적하면,

별도의 계산 없이 탐색과 동시에 rank(순위)를 구할 수 있다.

이 덕분에 ZRANK나 ZREVRANK가 O(log N)에 동작할 수 있다.


Hash Table — score 단건 조회 담당

Skip List는 범위 조회에 강하지만, "alice의 score가 정확히 얼마냐"는 질문에는 O(log N)이 걸린다.

전체 리스트를 탐색해야 하기 때문이다.


이걸 해결하기 위해 Redis는 member → score 매핑을 담은 Hash Table을 병행해서 유지한다.

Hash Table 덕분에 ZSCORE 명령은 O(1)에 답을 준다.

Hash Table │ { "alice": 1500.0, "bob": 1320.0, "carol": 1750.0 }
Skip List  │ bob(1320) → alice(1500) → carol(1750)

두 구조는 쓰기(삽입·삭제·갱신)가 일어날 때마다 함께 업데이트 된다.

쓰기 비용이 조금 늘어나지만, 읽기 패턴이 다양한 ZSet의 특성에 적합한 트레이드오프로 볼 수 있다.


결과적으로

범위 조회는 Skip List가, score 단건 조회는 Hash Table이 담당한다.


/* check if the element is too large or the list
 * becomes too long *before* executing zzlInsert. */
if (zzlLength(zobj->ptr)+1 > server.zset_max_listpack_entries ||
    sdslen(ele) > server.zset_max_listpack_value ||
    !lpSafeToAdd(zobj->ptr, sdslen(ele)))
{
    zsetConvertAndExpand(zobj, OBJ_ENCODING_SKIPLIST, zsetLength(zobj) + 1);
} else {
    zobj->ptr = zzlInsert(zobj->ptr,ele,score);
    if (newscore) *newscore = score;
    *out_flags |= ZADD_OUT_ADDED;
    return 1;
}


위 소스는 실제 레디스 소스를 일부 가져온 것인데, 특정 임계 치를 넘어가게 되면 Zset의 구조를 전환하는 코드를 확인할 수 있다(zsetConvertAndExpand)


마치며

ZSet은 정렬된 데이터를 빠르게 가져올 때 쉽게 사용하는데, 그 안에는 Skip List와 Hash Table을 역할에 따라 나눠 쓰는 꽤 정교한 설계가 들어 있다.

동작 구조를 살펴보니 해당 자료구조에 대한 이해도를 높일 수 있었고, 이를 통해 개발이나 운영 때 이러한 전환 구조에 따른 변화를 고려하고 참고 할 수 있을 것 같다.


참고

1) https://redis.io/docs/latest/develop/data-types/sorted-sets

2) https://github.com/redis/redis/blob/unstable/src/t_zset.c

반응형

'공부' 카테고리의 다른 글

안정 해시  (0) 2026.07.18
처음엔 빠른데 왜 나중엔 느릴까? 배치 Paging Reader의 함정  (1) 2026.04.16
대기열 - 시스템 안정성 높이기  (0) 2026.04.02
Command와 Event  (0) 2026.03.27
서킷브레이커를 알았더라면  (0) 2026.03.20
반응형

대기열은 왜 필요한가?

트래픽이 갑자기 몰리면 서버는 쉽게 무너진다.

티케팅, 선착순 쿠폰, 오픈런 이벤트 — 공통점은 하나다. 평소보다 몇십 배의 요청이 짧은 시간에 집중된다는 것이다.

이 문제를 해결하는 방법이 대기열(Waiting Queue)이다.


서버는 슈퍼맨이 아니다

Spring Boot 서버가 요청을 받으면 Tomcat 스레드 풀에서 스레드 하나를 꺼내 처리한다.

기본 설정은 최대 200개. 즉, 동시에 201번째 요청이 들어오는 순간부터는 앞선 요청이 끝나기를 기다려야 한다.


DB도 마찬가지다.

커넥션 풀(HikariCP)은 기본 최대 10개의 커넥션을 유지한다.

11번째 요청이 DB를 쓰려는 순간, 커넥션이 반환될 때까지 블로킹된다.


평소에는 요청 하나가 수십 ms 안에 끝나기 때문에 스레드와 커넥션이 빠르게 반환된다.

그런데 트래픽이 몇십 배로 폭증하면 이야기는 달라진다.


대기열이 없으면 어떤 일이 생기나

스레드 풀이 가득 찬다

요청이 폭발적으로 들어오면 200개의 Tomcat 스레드가 모두 점유된다.

이후 요청은 Tomcat 내부 accept queue에서 대기하다가, 그마저 넘치면 Connection refused로 거절된다.

[요청 폭주]
→ Tomcat 스레드 200개 전부 점유
→ 새 요청: 대기 or Connection refused
→ 응답 시간 급증

커넥션 풀이 고갈된다

스레드들이 각자 DB 커넥션을 잡고 처리 중이다.

커넥션이 10개인데 스레드가 200개면, 190개의 스레드는 커넥션을 기다리며 블로킹된다.

기다리는 시간이 길어질수록 스레드는 더 오래 묶이고, 새 요청은 더 오래 기다리는 악순환이 시작된다.

[DB 커넥션 대기]
→ 스레드가 커넥션을 못 잡고 블로킹
→ 스레드 점유 시간 증가
→ 결국 전체 스레드 고착 (thread starvation)

타임아웃 폭탄이 터진다

HikariCP의 기본 connectionTimeout은 30초다. 30초 동안 커넥션을 못 받으면 예외를 던진다.

수백 개의 요청이 동시에 30초를 기다렸다가 동시에 실패하면, 클라이언트의 재시도가 또 다른 폭주를 만든다.

상황은 오히려 더 악화된다.

연쇄 장애(Cascade Failure)로 번진다

문제는 한 서버에서 끝나지 않는다. MSA 환경에서는 서비스들이 서로를 호출한다.

주문 서비스가 느려지면, 연관된 다른 서비스도 영향을 받아 연쇄 장애로 번질 수 있다.


대기열이 하는 일

트래픽을 흡수한다

순간 폭주하는 요청을 일단 줄에 넣어두고, 서버가 소화할 수 있는 속도로 천천히 내보낸다.

서버 입장에서는 항상 일정한 속도의 요청만 처리하면 된다.

많은 인원이 동시에 몰려도, 서버는 정해진 인원만 처리한다. 나머지는 줄에서 기다린다.

순서를 보장한다

먼저 온 사람이 먼저 처리된다.

도착 시각을 기준으로 줄이 세워지기 때문에, 대기열에 진입한 후로는 집인 순서에 따라 공정하게 처리된다.

대기열 없이 수만 건의 요청이 동시에 DB에 도달하면 처리 순서는 사실상 랜덤이다.

먼저 클릭했어도 나중에 처리될 수 있다.

시스템을 지킨다

서버가 감당할 수 있는 범위를 초과하는 요청은 즉시 처리하지 않는다.

무리하게 받다가 전체가 다운되는 것보다, 정해진 속도로 처리하고 나머지는 기다리게 하는 것이 낫다.

대기열이 유입량 자체를 조절하기 때문에 스레드 풀, 커넥션 풀 등 자원의 고갈로 인한 문제를 예발 할 수 있다.


대기열의 흐름

사용자 입장에서는 이렇게 느껴진다.

1. 버튼 클릭 → "현재 347번째입니다. 예상 대기 시간 2초"
2. 주기적으로 순위 확인 → 숫자가 줄어든다
3. 내 차례 → 입장권(토큰) 발급
4. 입장권을 들고 → 실제 서비스 이용
5. 처리 완료 → 입장권 자동 소멸

입장권에는 유효 시간이 있다. 일정 시간 안에 사용하지 않으면 만료된다.

줄을 서다가 자리를 비운 사람이 자원을 점유하지 않도록 하기 위해서다.


대기열 X vs 대기열 O

  대기열 없음 대기열 있음
서버 상태 스레드/커넥션 고갈 위험 일정한 부하 유지
처리 순서 사실상 랜덤 도착 시각 기준 FIFO
장애 전파 연쇄 장애 가능 유입량이 제어되어 안전
사용자 경험 흰 화면, 알 수 없는 오류 몇 번째인지, 얼마나 기다릴지 안내
재시도 묻지마 재시도 → 2차 폭주 내 순서가 있으니 재시도 불필요


마무리

대기열은 불편한 것이 아니라 서비스를 지키는 안전장치다.

대기열 없이 트래픽 폭주를 그냥 받으면 서비스 자체가 다운된다.


반면 대기열이 있으면 늦더라도 "내 차례는 온다"는 신뢰를 줄 수 있다.

병목은 "동시에 너무 많이 들어오는 것"에서 시작된다.

대기열은 그 입구를 조절하는 기술이다.

반응형
반응형

들어가며

프레더릭 테일러의 과학적 관리법은 오래된 책처럼 보인다.

1911년에 출간되었고, 문제의 무대도 공장이다.

그래서 현재의 상황과 관련이 없을 것이라는 생각이 든다.

하지만 그러한 생각은 책을 읽어나가며 점점 생각은 달라지게 된다.


테일러가 묻는 것은 결국 하나다.

일을 잘하게 만드는 것은 개인의 감각과 숙련인가, 아니면 분석된 절차와 설계된 체계인가.

이 질문은 공장 노동의 시대를 넘어 오늘의 사무실, 플랫폼, 그리고 AI 협업 환경까지 길게 이어진다.


지금 우리가 생성형 AI와 AI agent를 두고 던지는 질문도 크게 다르지 않다.

- 무엇을 맡길 것인가.

- 어떻게 지시할 것인가.

- 어떤 기준으로 결과를 판단할 것인가.

- 어떻게 생산성을 향상시킬 것인가.


과학적 관리법은 과거의 책이면서 동시에 현재의  AI 시대를 이해하는 데 뜻밖의 도움을 주는 책이다.


과학적 관리법의 핵심 내용

책의 주장은 단순하다.

노동을 개인의 경험과 요령에만 맡겨 두면 비효율이 생긴다. 그러니 작업은 관찰되고, 분석되고, 측정되어야 한다.

그런 다음 가장 효율적인 방식을 찾아 표준으로 삼아야 한다. 생산성은 성실함만으로 생기지 않는다.

설계된 절차와 관리된 흐름이 있어야 한다. 이것이 테일러가 말하는 과학의 핵심이다.


이 논리는 산업사회에 큰 힘을 발휘했다.

작업은 더 잘게 나뉘고, 역할은 더 뚜렷해지고, 성과는 더 쉽게 비교되었다.

생산성은 개인의 감각이 아니라 조직의 시스템에서 나온다는 관점도 자연스럽게 자리 잡았다.


AI 시대와의 연결

AI 시대의 업무 환경은 겉으로 보면 테일러의 시대와 멀어 보인다.

이제 우리는 삽질의 각도보다 프롬프트의 구조를 고민하고, 물리적 동작보다 정보 처리의 흐름을 설계한다.

그러나 일을 대하는 태도만 놓고 보면 둘 사이에는 닮음이 있다.

더 좋은 결과를 얻기 위해 일을 분해하고, 절차를 정리하고, 반복 가능한 구조를 만들려 한다는 점이다.


오늘날 AI agent는 명확한 목표, 구체적인 조건, 분명한 평가 기준을 줄수록 더 안정적으로 작동한다.

반대로 지시가 흐리고 기대치가 모호하면 결과도 흔들린다.

이 사실은 아주 현대적인 기술 현상처럼 보이지만, 테일러의 언어로 옮기면 익숙한 그림이 된다.

성과는 우연히 나오지 않는다. 좋은 도구만으로도 나오지 않는다. 잘 짜인 구조 속에서 비로소 나온다.


이 점에서 과학적 관리법은 AI 시대에 꽤 유용한 책이다.

AI를 잘 쓴다는 것은 최신 모델을 안다는 뜻이 아니라, 일을 어떻게 나누고 어디서 검토하며 무엇을 인간의 몫으로 남길지 설계할 수 있다는 뜻에 가깝다.

생산성의 핵심이 기술 자체보다 관리 방식에 있다는 사실을 이 책은 말해준다.


이 책이 지금도 유효한 이유

이 책이 오늘도 유효한 이유는 단순하다.

성능 좋은 AI가 있다고 해서 조직이 저절로 효율적으로 변하지는 않는다.

오히려 도구의 성능이 높아질수록, 그 도구를 어떤 구조 안에 배치하느냐가 더 중요해진다.

목표가 흐리면 결과도 흐리고, 책임이 나뉘지 않으면 수정 비용만 커진다.


누가 초안을 만들고, 누가 검토하고, 어떤 기준으로 통과와 실패를 가를지 정하지 않으면 AI는 생산성의 도구가 아니라 반복 수정과 책임 공백을 낳는 혼란의 도구가 되기 쉽다.


바로 이런 지점에서 테일러의 통찰은 여전히 힘을 가진다.

그가 남긴 핵심은 공장 관리의 기술이 아니라, 생산성은 좋은 도구 자체보다 일을 어떻게 나누고 연결하고 점검하느냐에 달려 있다는 사실이기 때문이다.


맺음말

과학적 관리법은 한 세기 전의 책이지만, 지금 읽으면 놀랄 만큼 현재적이다.

그것은 이 책이 오늘에도 그대로 옳아서가 아니라, 우리가 여전히 효율의 언어 안에서 일하고 있기 때문이다.

테일러가 보았던 생산성의 문제는 사라지지 않았다.

다만 그 대상이 공장 노동에서 인간과 AI의 협업으로 옮겨왔을 뿐이다.


그래서 이 책을 지금 다시 읽는 일은 단지 오래된 경영 이론을 확인하는 일이 아니다.

오히려 어디까지 효율을 추구할 수 있는지, 그리고 어디서부터 인간의 판단과 책임을 남겨 두어야 하는지를 묻는 일에 가깝다.


AI 시대의 경쟁력은 기술을 먼저 들여오는 데서 생기지 않는다.

인간과 AI의 역할을 어떻게 나누고, 무엇을 표준화하며, 무엇만큼은 끝내 표준화하지 않을지를 정하는 데서 생긴다.

그런 의미에서 과학적 관리법은 낡은 고전이 아니라, 오늘의 노동과 생산성을 다시 생각하게 만드는 여전히 날카로운 책이다.

반응형

'' 카테고리의 다른 글

[책읽기] The Nature of Software Development  (1) 2026.05.01
반응형

처음 시스템을 만들 때는 대개 command 중심으로 출발는 것이 자연스럽다.
사용자는 어떤 동작을 요청하고, 시스템은 그 요청을 처리하면 된다.


그런데 시스템이 조금만 커지면 command만으로는 복잡해지는 순간이 온다.
어떤 동작의 결과를 여러 곳에서 알고 싶어지고, 후속 처리가 점점 늘어나고, 한 서비스가 다른 서비스의 내부 후처리까지 알아야 하는 상황이 생긴다.


그러면 command에서 event로 전환을 고민해볼 필요가 있다.


Command와 Event는 무엇이 다른가

Command는 의도를 담는다.

“이 일을 해라”라는 요청이다.


누군가 특정 수신자에게 어떤 행위를 기대하면서 보낸다.


예를 들어 다음과 같은 이름은 command에 가깝다.

  • CreateOrder
  • ApprovePayment
  • SendNotification

반면 Event는 이미 일어난 사실을 담는다.
“이 일이 일어났다”라는 기록이다.


누군가에게 뭔가를 시키는 것이 아니라, 시스템 안에서 발생한 사실을 알린다.


예를 들면 이런 식이다.

  • OrderCreated
  • PaymentApproved
  • NotificationSent


command는 행위의 책임을 특정 대상에게 전달하고, event는 발생한 사실의 전파를 시스템 전체에 열어둔다.

즉, command는 본질적으로 더 직접적이고, event는 더 느슨하게 연결된다.


처음에는 왜 Command로 시작하는가

많은 경우 command로 시작하는 것이 맞다.


사용자 요청은 대부분 명령의 형태로 들어온다.
“주문해줘”, “결제해줘”, “취소해줘”처럼 시스템에 기대하는 행동이 분명하다.

이때 command는 흐름을 이해하기 쉽고, 책임 주체도 명확하다.


예를 들어 주문 생성 유스케이스를 생각해보자.

  1. 사용자가 주문 생성 요청을 보낸다.
  2. 주문 서비스는 주문을 생성한다.
  3. 결과를 반환한다.

이 정도 규모에서는 command만으로도 충분하다.
오히려 event를 너무 일찍 도입하면 구조만 복잡해지고, 실제 이점은 크지 않을 수 있다.

문제는 시스템이 성장하면서 시작된다.


Event로 전환해야 하는 순간은 언제인가

핵심은 이 질문이다.

지금 이 메시지는 특정 행동을 시키기 위한 것인가, 아니면 이미 발생한 사실을 다른 주체들이 활용하도록 알리기 위한 것인가?


처음에는 주문 서비스가 주문을 만들고 끝난다.
그런데 어느 순간부터 주문 생성 이후 해야 할 일이 늘어난다.

  • 포인트 적립
  • 쿠폰 사용 처리
  • 재고 차감
  • 포인트 적립
  • 알림 발송

이걸 전부 주문 서비스가 직접 command로 호출하기 시작하면 어떤 일이 생길까?

주문 서비스는 점점 더 많은 후속 처리의 존재를 알아야 한다.


어떤 서비스가 있고, 어떤 순서로 불러야 하고, 실패하면 어떻게 해야 하는지도 고민해야 한다.
결국 “주문 생성”이라는 본래 책임보다 “주문 이후 벌어지는 모든 일의 오케스트레이션”에 가까운 역할을 하게 된다.


이때 필요한 것은 후속 처리를 향한 더 많은 command가 아니라,OrderCreated 혹은 OrderCompleted 같은 event다.


주문 서비스는 “주문이 생성되었다”는 사실만 발행하고,

포인트 서비스는 그 사실을 구독해서 적립하고,
알림 서비스는 그 사실을 구독해서 메시지를 보내고,
통계 서비스는 그 사실을 구독해서 집계하면 된다.


하나의 command 결과가 시스템 안의 여러 반응으로 확산되기 시작할 때, event 전환이 필요해진다.


예시: 주문 완료 이후

처음에는 이런 구조였다고 가정하면

  • CompleteOrder command를 받는다.
  • 주문 서비스가 주문 상태를 완료로 변경한다.
  • 주문 서비스가 포인트 서비스에 적립 command를 보낸다.
  • 주문 서비스가 알림 서비스에 발송 command를 보낸다.
  • 주문 서비스가 통계 서비스에 집계 command를 보낸다.

처음에는 단순해 보인다.


하지만 시간이 지나면 이런 문제가 생긴다.

  • 주문 서비스가 너무 많은 후속 책임을 안는다.
  • 새 기능이 추가될 때마다 주문 서비스가 계속 수정된다.
  • 일부 후속 처리 실패가 주문 완료 자체를 흔들 수 있다.
  • 장애가 전파되기 쉽다.
  • 테스트도 점점 무거워진다.

이 구조를 event 중심으로 바꾸면 이렇게 된다.

  • CompleteOrder command를 받는다.
  • 주문 서비스가 주문 상태를 완료로 변경한다.
  • 주문 서비스는 OrderCompleted event를 발행한다.
  • 포인트 서비스가 이를 구독해 적립한다.
  • 알림 서비스가 이를 구독해 메시지를 보낸다.
  • 통계 서비스가 이를 구독해 집계한다.

이제 주문 서비스는 “주문 완료”라는 핵심 사실만 책임지게 된다.


후속 처리는 각 서비스가 자신의 관심사로 가져간다.

이 변화의 본질은 단순한 비동기화가 아니라 책임의 방향을 다시 정리한 것이다.


그렇다고 항상 Event가 더 좋은 것은 아니다

여기서 흔히 생기는 오해가 있다.
event가 더 유연해 보인다고 해서 모든 것을 event로 만들면 안 된다.

예를 들어 반드시 성공 여부가 즉시 중요하고, 실패 시 사용자에게 바로 알려야 하며, 순서 보장이 핵심인 작업은 여전히 command가 더 적합하다.

대표적으로는 이런 것들이다.

  • 결제 승인 요청
  • 회원 가입 처리
  • 주문 취소 요청

이런 것은 “사실 알림”보다 “의도 전달과 결과 보장”이 더 중요하다.

또 하나 주의할 점은, event를 도입하면 구조가 느슨해지는 대신 추적 난이도가 올라갈 수 있다는 것이다.
동기 호출에서는 한 흐름으로 보이던 것이, 이벤트 기반 구조에서는 여러 소비자의 반응으로 퍼진다.
그래서 idempotency, 재처리, 중복 소비, 순서 보장, 모니터링 같은 운영 관점도 함께 고려해야 한다.

즉, event 전환은 무조건적인 업그레이드가 아니라 다른 종류의 복잡성을 선택하는 일이다.


판단 기준을 한 문장으로 정리하면

내가 이 메시지로 정말 하고 싶은 것이

  • 특정 대상에게 어떤 행동을 시키는 것이라면 command이고,
  • 이미 발생한 사실을 다른 주체들이 활용하게 하는 것이라면 event다.

그리고 특히, 하나의 도메인 결과가 여러 시스템의 반응을 유발하기 시작하면
그 시점부터는 command를 더 추가하는 대신, 결과를 event로 승격시키는 편이 더 자연스럽다.


내가 경험에서 적용할 수 있는 포인트를 고민해보면

주문을 다루는 실무에서는 하나의 command가 점점 많은 일을 맡게 되는 순간이 있다.
실제로 주문을 생성하는 과정 안에는 임직원 할인 적용, 프로모션 계산, 최종 주문 생성, 포인트 적립처럼 서로 성격이 다른 로직들이 자연스럽게 함께 들어오게 된다.


처음에는 하나의 흐름으로 묶여 있는 것이 단순해 보이지만, 시간이 지날수록 주문 command가 주문 자체를 처리하는 것을 넘어 주문 이후의 반응까지 모두 책임지는 형태로 커지기 쉽다.


이럴 때 중요한 것은 command가 단순히 커졌다는 사실보다, 그 안에 섞인 책임이 정말 같은 성격이냐는 점이다.
예를 들어 임직원 할인이나 프로모션 적용은 주문을 어떤 조건으로 생성할지를 결정하는 핵심 흐름에 가깝다.

반면 포인트 적립은 주문이 정상적으로 생성된 이후에 이어지는 후속 반응으로 볼 여지가 크다.


이런 식으로 주문을 성립시키는 책임과 주문 이후에 반응하는 책임이 한 command 안에 함께 들어오기 시작한다면, 그때는 event로의 분리를 한 번쯤 고민해볼 만하다.


결국 실무에서 event 전환을 고민하게 되는 지점은 로직의 양이 많아졌을 때라기보다, 하나의 command가 여러 관심사를 함께 끌어안기 시작할 때에 더 가깝다.


주문 생성은 command가 책임지고, 그 결과에 대한 포인트 적립이나 다른 후속 처리는 OrderCreated 같은 event를 통해 풀어내는 방식이 구조를 더 자연스럽게 만들어줄 수 있다.


마무리

command에서 event로의 전환은 기술 스택의 문제가 아니다.
Kafka를 쓰느냐, 메시지 브로커를 쓰느냐의 문제도 아니다.
본질은 시스템 안에서 무엇을 “의도”로 보고, 무엇을 “사실”로 볼 것인가에 대한 모델링의 문제다.


처음에는 command로 시작하는 것이 맞다.
하지만 시스템이 커지면서 후속 반응이 많아지고, 여러 관심사가 얽히고, 한 서비스가 다른 서비스의 내부 사정을 너무 많이 알게 된다면, 그때는 질문을 바꿔야 한다.


“다음 command를 어디로 보낼까?”가 아니라 “여기서 정말 중요한 도메인 사실은 무엇인가?”

결국 command에서 event로의 전환은 메시지 종류를 바꾸는 일이 아니라, 시스템 안에서 요청과 사실을 다시 구분하는 과정에 가깝다.


중요한 것은 기술 선택이 아니라, 도메인의 사실을 정확하게 포착하고 그것을 중심으로 경계와 책임을 나누는 일이다.

좋은 설계는 command와 event 중 하나를 택하는 것이 아니라, 둘이 가장 자연스러운 자리를 찾게 만드는 데서 시작된다.

반응형

+ Recent posts